Aufzeigen von Abhängigkeiten in einer Service-basierten Architektur
Architekturkonforme Kommunikation durch Analyse von Middleware-abhängigen Service-Interaktionen sichergestellt und bessere Entscheidungsgrundlagen für Systemänderungen geschaffen.
In einer über Jahre entstandenen Service-basierten Architektur in Java, kam die Frage auf, wie die gegenseitige Abhängigkeit der Services über Middleware-Kanäle aussieht, und ob Konnektivität gemäss den Architekturvorgaben sind.
Problemstellung
Da mit den Services sowohl über synchrone (https/REST) wie auch asynchrone Kanäle (amqp/Messaging) kommuniziert wird, sind die Abhängigkeiten nicht offensichtlich. Dies insbesondere dann, wenn beteiligte Entwickler sich wissentlich oder unwissentlich nicht an die Architektur-Vorgaben gehalten haben. Im Architektur-Team wollte man darüber Bescheid wissen.
Lösungsweg
Damit diese Abhängigkeiten bestimmt werden konnten, mussten:
Die entsprechenden Artefakte im Code aufgespürt werden
Die effektiven Verbindungen pro Service in den Konfigurations-Files ausfindig gemacht werden
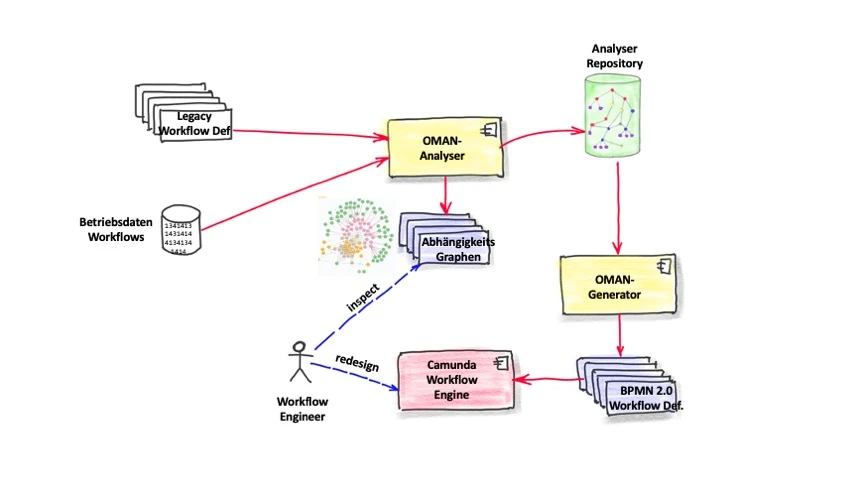
Entsprechend wurden sowohl der Code wie auch die Konfigurations-Artefakte in die Analyse miteinbezogen. Im Code konnten die REST-Ressource-APIs recht einfach gefunden werden. Doch, da diese aus dem Code nicht direkt sondern über Adapters in einer Applikations-Bibliothek aufgerufen werden, musste dieser Indirektions-Schritt mit einbezogen werden. Auch bei der asynchronen Kommunikation mit Messaging für Point to Point und Publish/Subscribe wurde eine spezielle Bibliothek verwendet, welche die darunter verwendete JMS-Kommunikation abstrahiert und für die Entwickler vereinfacht hat.
Da sowohl bei der synchronen wie bei der asynchronen Kommunikation keine Destinations-Adressen im Code vorhanden sind und sein sollten, musste auf die Konfigurations-Artefakte zurückgegriffen werden.
Resultat
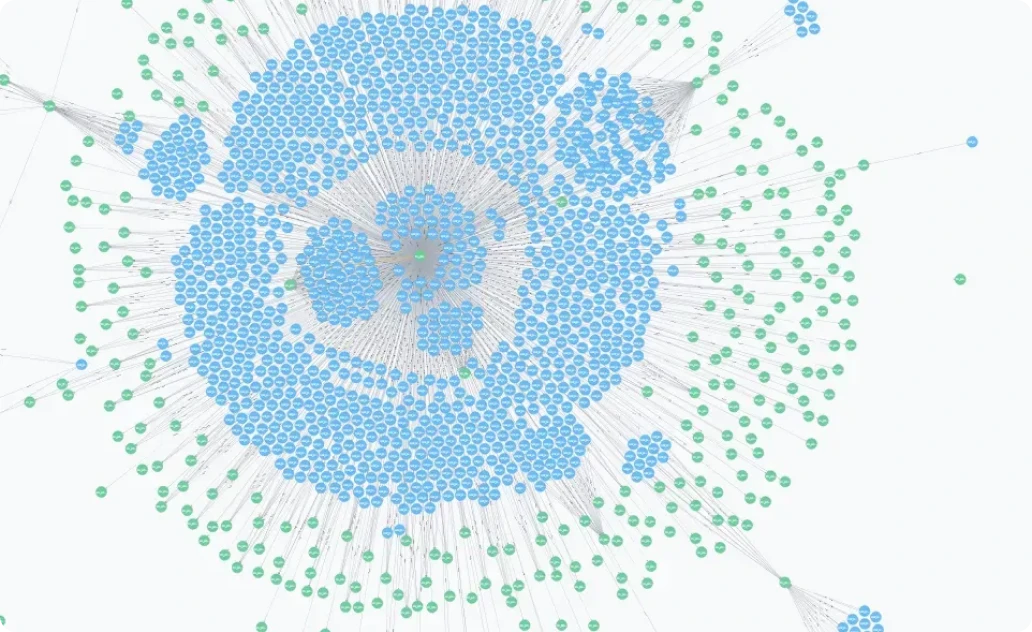
All diese Artefakte richtig eingeordnet und daraus die Abhängigkeiten ermittelt, hat dann die Kommunikations-Graphen aller Services untereinander aufgezeigt.
Service-Abhängigkeiten über Endpoints
Man konnte damit schnell feststellen, welche Folgen bei einer Anpassung von Schnittstellen oder Code, welcher Schnittstellen beeinflusst zu erwarten sind. Dies auch, wenn im Code eine direkte Abhängigkeit nicht aufgezeigt würde.
Abhängigkeiten der Services über asynchrone Middleware
Ebenso sind, wenn auch wenige, Anomalien und Architekturverstösse aufgefallen, welche dann behoben oder durch ein Re-Design korrigiert werden konnten.
Fazit
Durch diese Domänen-übergreifende Analyse konnten Abhängigkeiten aufgezeigt werden, welche gerne verborgen bleiben. Auch wenn die Code-Abhängigkeit in einer Microservices grundsätzlich geringer als in einem Monolithen ist, kommen Abhängigkeits-Aspekte via die Kommunikations-Middleware zum tragen, welche in der Regel schlecht oder unvollständig dokumentiert sind. Diese Kommunikations-Abhängigkeiten führen öfter zu unbequemen Überraschungen im falschen Zeitpunkt. Mit einer automatisierten Analyse und dynamischen Dokumentation kann diesem Umstand entgegen gewirkt werden.
Die System Discovery liest jede Schicht eines Systems – Code, Konfigurationen, Datenbankschemas, Prozessdefinitionen, Excel-Listen – und verbindet sie zu einem Wissensgraphen. Ihre Fachleute und Ihre KI-Werkzeuge können ihn direkt befragen. Typischerweise dauert sie zwei bis sechs Wochen.
Welcher Service ruft welchen auf? Der Graph weiss es.
Sie müssen noch nicht wissen, welchen Baustein Sie brauchen. Im Erstgespräch klären wir, welche Frage zählt und welche Quellen sie beantworten. Danach entscheiden Sie, ob und wie es weitergeht.
Sie schreiben uns
Ein Satz zu Ihrem Vorhaben genügt. Kein Briefing, keine Unterlagen, keine Vorbereitung.
Erstgespräch, 30 Minuten
Wir hören zu und zeigen, welche Analyse für Ihre Situation richtig ist. Und wenn wir nicht passen, sagen wir auch das.
Klarer Plan, fester Rahmen
Ein konkreter Vorschlag: was wir untersuchen und was Sie danach über Ihr System wissen. Erst dann entscheiden Sie, ob wir anfangen.